WeiWei Sports AI Model
韦德体育AI大模型:面向直播、短视频、社交、舆情与粉丝商业的体育媒体模型组合
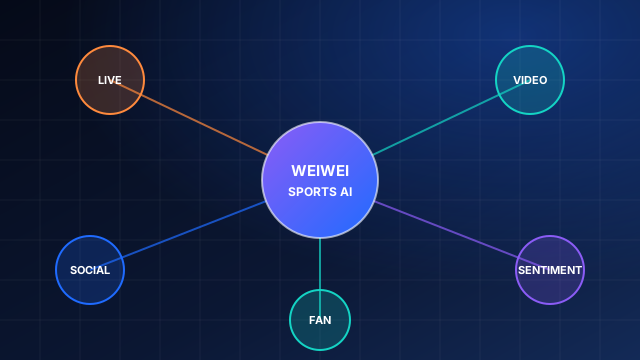
韦德体育AI大模型不是一个普通聊天模型,而是视频理解、精彩片段识别、情绪分析、推荐排序、观众分析和Sports CRM的组合,由Sports Media Agent统一调度,并始终保留清晰的数据边界与人工审批环节。
很多人听到“体育AI大模型”,第一反应是一个能回答比赛问题、能写战报的聊天机器人。韦德体育AI大模型不是这样设计的。体育媒体的商业问题——哪个片段值得剪、这波讨论是机会还是风险、哪些球迷可能流失、广告插在哪个时刻最不打扰观看——需要的是看得懂视频、读得懂评论、算得清用户行为的多个专门模型,再由一个会调度它们、会给出建议、也清楚自己边界的智能体串起来。本页说明这套模型由哪些部分组成,各自解决什么问题,可能在哪里判断错,以及哪些动作必须由人审批。
为什么不是一个普通的聊天大模型?
通用聊天模型擅长语言,但体育媒体的输入大多不是语言:直播流是视频,观看和点击是行为日志,会员和商品是交易记录。让一个聊天模型直接“看”一场90分钟的比赛再判断商业价值,既慢,又容易编造它没有看到的细节。韦德体育的做法是把能力拆开,每个模型只做它擅长且可以被单独验证的事;语言模型负责理解指令、组织解释和起草内容,而不是替代视频理解和行为分析。
这样设计还有一个现实原因:体育媒体团队问的问题通常带着业务上下文。“这条集锦为什么没火”背后,可能是片段选错了,可能是发布时间撞上了另一场焦点比赛,也可能是标题和平台用户不匹配。一个只会生成流畅回答的模型,往往会给出听起来合理却无法验证的解释;而由专门组件分别给出证据,再组织成结论,团队才能判断这个解释到底站不站得住。
Video Model→Highlight Detection→Sentiment Model→Recommendation Model→Audience Analytics→Sports CRM→Sports Media Agent
七个组件分别负责什么?
| 组件 |
输入 | 输出 |
对应能力 |
| Video Model | 直播流、比赛回放 |
画面事件、镜头类型、球员出镜 |
Sports Streaming AI |
| Highlight Detection |
比赛事件、现场声音、评论热度 |
候选精彩片段及排序 | Highlight AI |
| Sentiment Model |
评论、弹幕、帖子 |
话题、情绪、来源结构 | Sentiment AI |
| Recommendation Model | 内容特征、平台特征 | 发布时机、版本与分发建议 | Social Media AI |
| Audience Analytics |
观看与互动日志 | 留存、分群、行为路径 |
Sports Streaming AI、Fan AI |
| Sports CRM |
已授权的会员与消费数据 |
生命周期阶段、长期价值区间 | Fan AI |
| Sports Media Agent |
以上组件的输出 |
下一步内容与商业动作建议 | Sports Media Agent |
拆开的好处是出错时能定位:如果一条建议不靠谱,可以追查是片段识别错了、情绪判断错了,还是分群口径有问题,而不是面对一个无法解释的整体输出。
Sports Streaming AI与Highlight AI:看懂比赛,也看懂观众
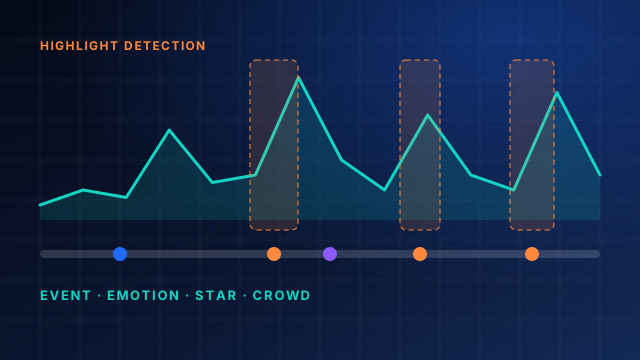
Sports Streaming AI处理直播本身:把画面事件、比赛状态和观众行为对齐到同一条时间轴,回答“某个时刻观众为什么离开或留下”。Highlight AI在此基础上挑片段,它不只看进球和射门这类数据事件,还会参考现场声音、解说语气、球星出镜和评论的瞬时热度。数据上重要但观感平淡的事件,和没有进球却让全场起立的瞬间,是它最需要区分的两类情况,具体方法见一场比赛几十个精彩瞬间,AI应该选哪几个做短视频。
Social Media AI与Sentiment AI:先理解讨论,再决定发什么
Social Media AI负责内容适配和发布建议:同一个进球,在不同平台需要不同的时长、画幅、标题和Hook。Sentiment AI负责理解讨论本身,把情绪拆成话题、来源、人群和商业关联,而不是只输出正负面比例。它的已知弱点是反讽、调侃和球迷圈内用语,所以低置信度的判断会被标记出来交给人工复核,见体育舆情分析为什么不能只分成正面、负面和中性。
Fan AI:长期价值不等于今年花了多少钱
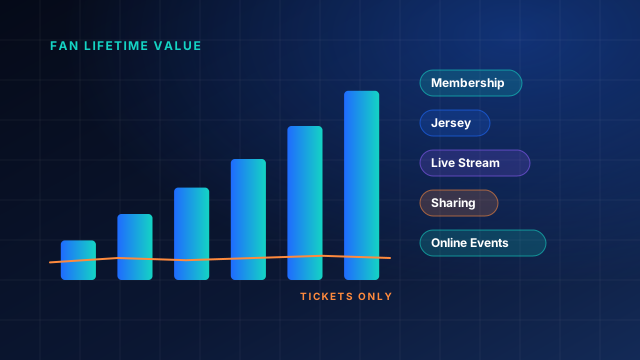
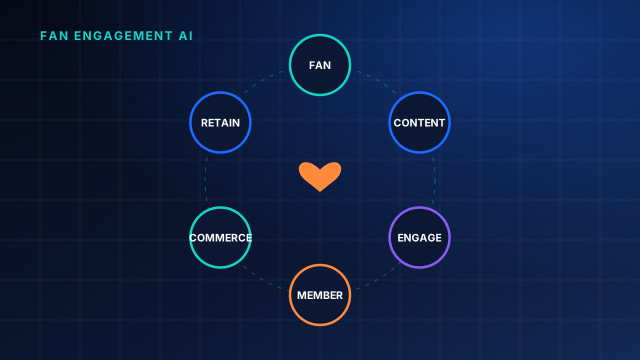
Fan AI建立在Audience Analytics和Sports CRM之上,关注的是球迷的长期关系:持续观看、分享内容、参加线上活动、续费会员,这些行为都可能比一次高价门票更能说明长期价值。这里最容易被误读的是流失判断:一个球迷休赛期三个月没有消费,但仍在看训练短视频、在评论区互动,这更像季节性沉默,而不是离开。Fan AI会把观看、互动和消费放在一起看,并考虑赛季周期。模型给出的是分群结果和估计区间,而不是对某个人的确定判断,相关思路见一个从不买高价门票的球迷,为什么仍然可能拥有很高的长期商业价值。
Sports Media Agent:从发现信号到提出下一步
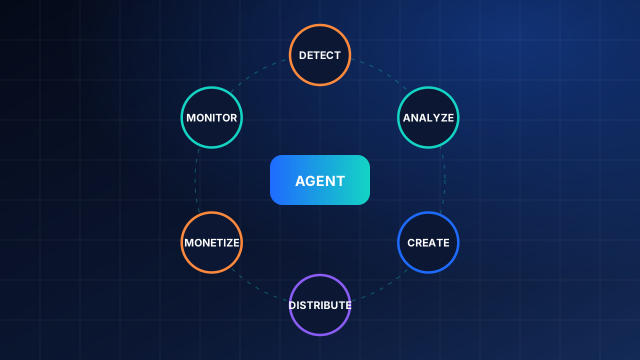
Sports Media Agent是这套组合的调度层,按Detect、Analyze、Create、Distribute、Monetize、Monitor的顺序工作:发现一个信号,调用对应模型分析原因,起草内容,建议分发方式,提示商业机会,再持续观察结果。
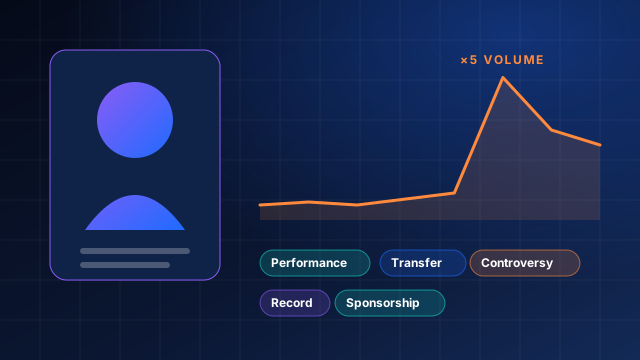
模拟场景假设某中锋的一条短视频在发布后6小时内互动量达到同类内容平均值的3倍。Agent会继续查询:他所在比赛的直播回看是否增加、新增关注用户来自哪里、相关球衣商品页点击是否上涨、会员页访问有没有变化。如果多个信号同向,它会建议追加一条训练花絮并在商品页增加相关推荐;如果只有短视频互动在涨,它会建议先观察,不做商业动作。以上数字均为假设。
完整的推理链与审批设计见下一代体育媒体AI为什么会变成主动寻找球迷商业机会的Sports Media Agent。
数据边界:模型能用什么,不能用什么?
- 只使用客户项目中已授权接入的数据,不从未授权平台抓取个人信息
- 球迷数据以分群和聚合形式参与分析,个体明细不出现在对外输出中
- 不同客户的项目数据相互隔离,不用于训练面向其他客户的模型
- 涉及未成年人的账号和数据默认排除在个性化推荐之外
- 模型输出附带依据和置信度,低置信度结论标记为需复核
边界不只是规则,也要能被检查。项目管理员可以在项目设置里看到当前接入了哪些数据源、授权范围和授权期限,随时解除某个授权;Agent每次提出建议时,会列出它调用了哪些组件、依据了哪些数据,方便团队回溯。如果某条建议依赖的数据不在授权范围内,它会直接提示“数据不足”,而不是用猜测补齐。
哪些动作必须由人审批?
AI可以发现、排序、分析和起草,但以下动作不会自动执行:对外发布内容、调整广告投放和插播时机、修改商品价格或会员权益、回应争议事件、向品牌方提交运动员评估结论。这些动作影响真实用户和商业关系,一旦出错,代价远大于节省下来的时间。模型也确实会判断错:把短期讨论高峰误认为长期热度,把一次争议带来的关注误认为商业价值,把休赛期的沉默误认为流失。审批环节正是为了拦住这些错误。这些能力在日常工作中如何使用,可以查看韦德体育App。